现代密码学基础
- 学习视频:斯坦福大学《密码学|Cryptography 1》
- 这门课主要是讲现代密码学的工作原理,不仅学习的是数学基础、加密算法,还会学到安全的密码学模型,以及如何证明某个密码学方案在某个条件下是安全性的。
现代密码学简介
初步介绍
-
密码学无处不在,是保护数据的常用工具,在日常生活中,有一些常见的地方:
- 密码学使用在安全通信中:
- 网页流量:
HTTPS协议保护(实际上是SSL,有时候也会叫TLS) - 无线流量:
wi-Fi流量通过WPA2协议保护,手机流量通过GSM中的加密机制保护,蓝牙流量也会通过密码学保护。
- 网页流量:
- 密码学使用在存储介质和文件中:加密文件系统
EFS,加密磁盘TrueCrypt,购买DVD和蓝光光盘上面的电影也会经过加密。
- 密码学使用在安全通信中:
-
在密码学中,目前有两种比较加密方式:
- 第一种是:非对称加密,也称为公开密钥加密,可以在
SSL握手的时候进行密钥的交换。 - 第二种是:对称加密,对称加密一般就是用来保护通信流量的基础构件。其中对称加密对于密钥的使用有如下俩种情况:
- 一次密钥
one time key:一个密钥只被用于加密一次消息,当要加密下一个消息的时候就会重新换一个新的密钥。例如:发送电子邮件,就是一个密钥加密一封电子邮件。 - 多次密钥
many time key:一个密钥被用于加密多个消息,这种情况下需要更多的机制来确保密钥的安全性,这些机制被称为加密模式。例如:加密文件,就是用一个密钥加密多个文件。
- 一次密钥
- 第一种是:非对称加密,也称为公开密钥加密,可以在
-
密码学一些名称的约定:
Alice、Bob和Eve:是三个人名,用于形象描述加密算法、密钥交换的具体过程所用的人名。- 加密五元组:
K是密钥、E是加密算法、D是解密算法、m是明、c是密文
-
现代密码学是非常严谨的一门学科,当我们出现一个新的密码学原语时,每个概念必须遵循三个非常严谨的步骤:
- 精确地指出威胁模型。例如:攻击者可以做什么来攻击数字签名,以及他伪造的目标是什么。
- 提出一个构造。
- 证明在威胁模型下攻击该构造将解决一个潜在的困难问题。
具体领域
- 安全通信,一般分为两个部分:
- 第一部分:安全密钥建立,也就是使用一定的协议,使得
Alice和Bob互相发送消息,在协议结束时,他们都有一个共享密钥,并且攻击者不知道这个密钥。 - 第二部分:使用共享密钥后进行安全通信,在获得共享密钥后,就可以使用该密钥发送消息,使得攻击者无法弄清楚来回发送消息的内容,以及攻击者无法在不被发现的情况下篡改消息的内容。
- 第一部分:安全密钥建立,也就是使用一定的协议,使得
- 数字签名:是物理世界中的签名,在数字世界中的迁移与模拟。
- 基本思路:将数字签名当作是被签署内容的函数,这样数字签名就不会被盗用等。
- 匿名通信:用户与服务器进行通信,但是服务器不知道用户的真实身份。
- 标准方法之一:混合网络,
Alice通过一系列代理在公共互联网上与Bob通信。 - 匿名通信是双向的,即使
Bob不知道与谁在交流,他也能回复和他在交流的人。 - 可以通过匿名通信,构建其他隐私机制,例如:匿名数字现金,但是在提供匿名数字现金的同时,需要防止
Alice在不同商家处重复使用同一个数字硬币进行支付。
- 标准方法之一:混合网络,
- 密码学协议:
- 具体例子:
- 在不记名投票中,通过加密的方式对投票数进行统计,并且计算出获胜者,并且不能暴露参与投票者的信息,并且能验证某人是否有资格投票,某人是否投了多张票。
- 在私人拍卖中,也会使用到一些密码学协议,在维克瑞拍卖的规则下,获胜者是出最高价的人,但是获胜者支付的金额实际上是第二高出价,通过协议要做的是使参与者能够计算,从而找出最高价者,以及其支付的金额,并对任何出价者的信息保密。
- 其中一个不安全的方法就是引入可信第三方,将这些投票、拍卖喊价都给这个第三方,然后通过第三方可信机构进行计算,并公布结果。
- 具体例子:
- 其他使用例子:
- 私有计算外包:比如
Alice需要查询某个东西,他将要查询的东西加密后发送给Google进行查询,Google只能看到加密的内容,并搜索Alice想要查询的内容,搜索到之后这个结果还是会以加密的形式传给Alice,Alice在自己的电脑上将查询的结果解密。 - 零知识证明:比如存在,并且
Alice知道分解的因数,Bob只知道,现在Alice要向Bob证明她知道的因数分解,但是Bob不会了解到的任何信息。
- 私有计算外包:比如
离散概率
概率的定义
-
在古代,许多自然的密码构造都被发现是不安全的,因此现代密码学发展成为了一门严谨的科学,在构造加密方案的时候,总需要伴随着安全性的证明。
-
要证明加密方案的安全性,就需要用到离散概率的知识来描述和证明这个加密方案是安全的。
-
离散概率总是定义在一个有限集合中,离散概率是关于集合的一个函数:
- 例子1:,表示由构成的字符串集合,其中,表示长度是并且只由构成的字符串。
- 而该集合的离散概率,为,表示的是这个对应法则是将中的元素全部都映射到这个区间中,并且要满足所有映射的结果之和要为。
- 例子2:,假设等可能的随机抽取到该集合中的字符串,那么对于该集合的离散概率的值其实就是,此时会满足。
- 例子3:,假设不能等可能的抽取到这些字符串,其中
-
几个典型的离散概率:
- 均匀分布
Uniform distribution:对于,,其中表示集合中元素的个数。这个分布在上面例子2中介绍了。 - 点分布
Point distribution:在点处的点分布,其中,其实就是将所有的概率权重都放在一个点上。
- 均匀分布
-
分布向量:由于集合是有限集合,所以该集合中所有元素映射的值可以写成向量的形式,例如:
事件的概率
- 事件是一个集合,称为,它是有限集合的一个子集,并且我们定义$Pr[A] = \sum_{x \in A}P(x) ,Pr[A]\in [0,1] $。
- 表示事件的概率,而国内的教材其实表示事件的概率直接使用表示了。这里对事件的概率和集合中各个元素的概率做了严格的区分。
- 表示事件的概率,所以的概率比如是在之间的。
- 例如:,其中定义事件
- 事件表示的就是集合中最低的两个比特位是的元素。
- 在均匀分布的条件下,集合中,。
- 事件概率的并集界:
- 对于两个事件来说,这里两个事件的并事件的概率有一个上界
- 当两个事件互斥时,即,此时概率才满足
随机变量
- 定义:随机变量也是一个函数:
- 例子1:,
- 从该例子中这个随机变量映射到的值其实就是,并且我们定义一个随机变量这个映射规则,其实就是将长度为的字符串映射输出的最低有效位。
- 假设上面的例子符合均匀分布,那么,,
- 本质上就是将详细但是比较长的事件描述,抽象简化成数字或者是字母。
- 注意1:这里之所以比较绕是因为,随机变量是一个函数,而我们之前学的函数中变量就是变量而不是一个函数。
- 注意2:如果我们有一个在某个集合中取值的随机变量,那么这个随机变量实际上在集合中就会诱导出一个分布,也就是。
- 意思是变量输出中元素的概率等于我们在全集中抽样一个随机元素,然后再使用函数计算出输出为的可能性有多大。
- 输出的概率与事件概率相同,当我们在全集中抽样一个随机元素时,该元素落入函数下的原像中
- 例子1:,
- 均匀随机变量
uniform random variable:- 设集合是全集,有一个随机变量,记为集合上的均匀随机变量,对于,其中表示的就是随机变量从集合均匀抽样,表示随机变量是一个均匀随机变量在集合上的抽样。
- 形式上,均匀随机变量是一个恒等函数,
- 均匀随机变量之间的运算:设是集合的一个均匀随机变量,定义随机变量,其中表示元素末尾的值,表示元素倒数第二个的值,那么
随机算法
- 确定性算法与随机算法:
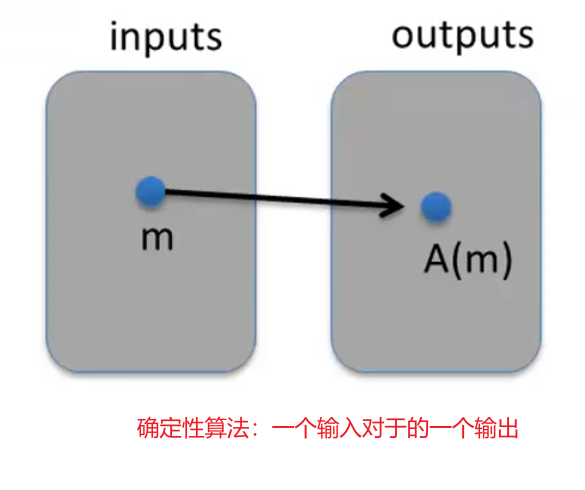
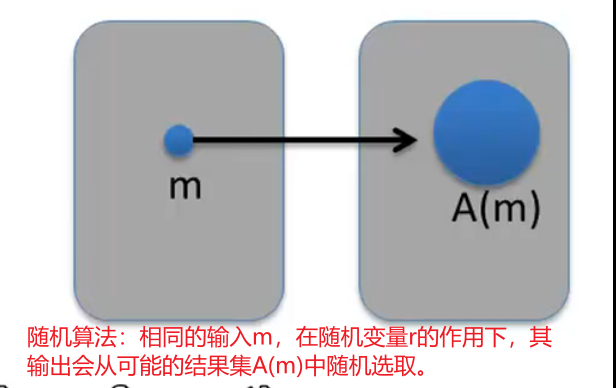
- 确定性算法:相同的输入一定为出现相同的输出,,其实就可以相当于将其看作函数。
- 随机算法:将相同的作为初始输入,并且引入一个隐式参数,每次运行程序的时候都会重新采样(是从所有比特字符串的集合中均匀随机采样的也就是),在每次运行程序输入的时候会得到不同的输出,因为每次都会生成不同的,。
- 例如:加密算法
独立性和一些定理
-
独立性:
- 事件的独立性:对于事件、是独立事件
- 随机变量的独立性:假设有两个随机变量和,它们再某个集合中的取值相互独立
- 例如:对于全集,并且有,定义和为,,这样
-
异或:两个二进制数的异或就是在进行每一位的模2加法
-
异或的重要性质:是一个在上的任意分布,假设有一个独立的随机变量在,并且和这两个随机变量是相互独立的,则在上也是均匀分布的。
- 证明:只考虑的情况
- 是上的任意分布,所以,且;而是上的均匀分布,所以
- 通过下面表可以得到,异或后
- 由于是相互独立的且事件中经过
or连接的事件并没有交集部分,所以就有 - 所以,当,在上是均匀分布的。
- 证明:只考虑的情况
| X | Y | XY |
|---|---|---|
| 0 | 0 | 0(0+0 mod 2) |
| 0 | 1 | 1(0+1 mod 2) |
| 1 | 0 | 1(1+0 mod 2) |
| 1 | 1 | 0(1+1 mod 2) |
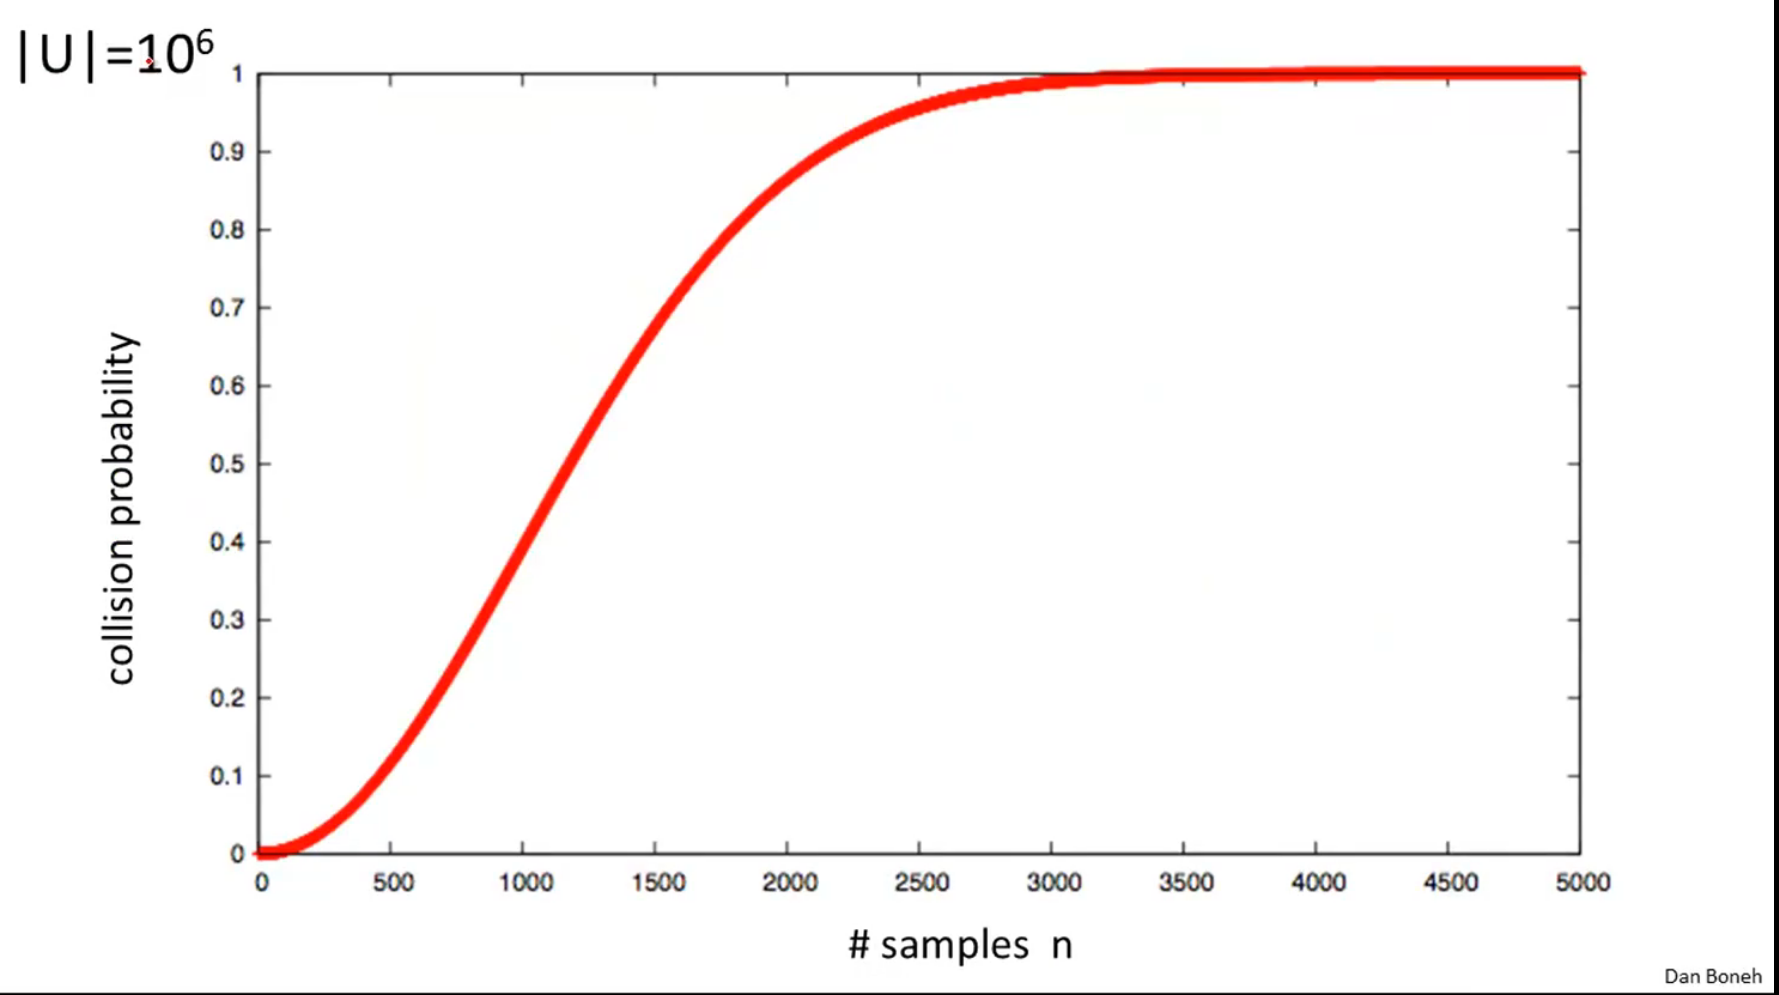
- 生日悖论:设在集合中选择个随机变量,即其中是相互独立且分布方式相同(分布方式相同,但并不意味着都是均匀分布),当的时候,
- 例如:,从中随机采样次那么其中可能会存在一组相同的样本。
- 下图中展示了,随机采样次,其中横坐标代表的是样本数量,纵坐标表示碰撞的概率。随着采样次数的增多,碰撞的概率会更高,大约在
n=5000时概率就接近1。
现代密码初步
密码
- 对于现代密码学,需要重新对密码下一个定义了。
- 密码的定义:
- 密码由五元组组成,其中是密钥空间,是明文空间,是密文空间;是一对高效的算法,其中是加密算法,是解密算法。
- 加密算法满足:
- 解密算法满足:
- 密码的一致性:对于,都有;该式子通过解密算法还原出原始消息,故该式子被称为一致性方程,每个密码必须满足一致性方程才能成为密码,否则不能解密。
- 注意1:
高效在密码学的不同情景中有着不同理解。- 偏向密码学理论的
高效指的是在多项式时间内运行,此时E,D必须关于要加密消息的大小n的多项式关系时间内运行。 - 偏向密码学实际运用,
高效意味着在特定的时间段内运行,例如:实际要求加密算法需要在1分钟内加密1PB的数据或者消息才算高效。
- 偏向密码学理论的
- 注意2:加密算法通常是一个随机化的算法;解密算法总是一个确定性算法。
安全的密码
- 安全的密码最主要的就是完美保密性,但其实还有语义安全等安全性。
安全的密码定义
-
在现代密码学中,一个密码满足密码的定义还不够,还得要满足安全的密码才能够被使用,所以在满足该密码的基本定义后,我们还需要证明该密码的安全性。
-
密码的安全性的基本原则:密文不能透露明文的任何信息。
-
安全的密码形式化定义如下(完美保密性):
- 一个密码是完美保密的就会满足如下:
- 总有,其中是上的均匀分布即$k\xleftarrow{R}K $
- 注解1:根据上面的定义,我们其实可以知道使用唯密文攻击是不可能攻击成功具有完美保密性的密码。
- 注解2:具有完美保密性的秘密,并不意味着该密码在实际中是安全可用的密码。
补充1:密码的完美保密性的定义与信息论有关,第一个严格研究密码安全性的人是
信息论之父香农Claude Shannon,他在1949年发表了一篇著名的论文,分析了一次性密码本的安全性。补充2:香农在证明一次性密码本
OTP的完美保密性之后,又证明了另一个定理,如果一个密码具有完美保密性,那么这个密码中的密钥数量必须不少于密码能处理的消息数量,即上面的这两个补充的都可以在这篇论文中看到:shannon-secrecy.pdf
一次性密码本
-
第一个安全的密码是由
Vernam在20世纪初设计,被命名为一次性密码本The One Time Pad,OTP。 -
一次性密码本的定义如下:
-
,其中密钥是一个随机比特序列,与要加密的消息一样长,
-
对于,对于
-
一次性密码本的一致性:,一致性得证。
-
-
注解1:对于
OTP来说,已知明文m和对应的密文c会很容易得到密钥k,即 -
注解2:在
OTP中,这俩个算法是非常高效的,但OTP在实际中并不会被使用,因为使用其加密需要安全地传递与消息等长的密钥,那有这种安全传输密钥的办法其实可以直接用来传输消息。 -
下面证明
OTP的完美保密性:-
通过完美保密性的定义我们知道,需要有
-
那其实只要证明为常数即可,而
-
而从上面一次性密码本中可以得到,,这就使得某个消息空间的消息,映射到密文空间的某个密文的密钥是唯一的,所以满足条件的密钥个数为
-
此时就有
-
因此,所以完美保密性得证。
-
对称加密
流密码
流密码的定义
-
OTP给我们提供了一种安全的加密思路,根据OTP的这种加密和解密的方式,产生了对称密码中的流密码。 -
流密码的基本思想:不使用完全随机的密钥,而使用的是伪随机的密钥,因此引入了伪随机数生成器
PRG,Pseudo-random generator -
PRG的定义:PRG是一个函数,该函数是从PRG使得一个长度很小的种子,可以生成一个长度很大的数,例如:我们取一个只有128位的种子,并将其扩展成一个很长的字符串,可能会达到千兆字节。- 高效性:PRG必须是高效可计算的,通过确定性算法高效可计算(因此PRG中的函数并不是随机性的,输入到伪随机函数中的种子)
区分:
PRG,Pseudo-random Generator是伪随机生成器,更偏向理论理论,有严格安全性定义的理论对象
PRNG,Pseudo-random Number Generator是伪随机数生成器,更偏向于实际工程,最广泛的工程统称,泛指一切看起来随机的生成器
-
流密码的构造:
- 使用种子作为密钥
- 使用
PRG将种子扩展成一个比种子大得多的看似随机的序列 - 将伪随机序列与消息进行异或得到密文c,即
- 注意:流密码不具有完美保密性,因为,因此密码学家又引入了另外的安全性定义,在此安全性的定义下流密码是安全的。
-
流密码的安全性定义:流密码的安全性取决于我们使用特定的生成器,
PRG生成器必须具备一个特定属性,也就是PRG必须是不可预测的。PRG可预测的定义:,使得,其中是不可忽略的,例如PRG不可预测的定义:在不可忽略的下预测出位- 当随机数可是预测的时候,举个例子就能知道流密码是在这种情况下是不安全的:
- 如果使用流加密,且攻击者掌握一部分密文,并且这部分密文对应的消息是固定的,就像
SMTP协议中的每个消息都以from colon开头; - 由于流密码的密文是
PRG生成的二进制位与消息的异或的结果,这就使得攻击者知道PRG输出的某些序列,若该PRG不安全,例如在时该PRG就能被预测出后续的输出序列,那么攻击者就可以破解出消息了。 - 事实证明,即使我们只能预测出
PRG后续输出的一个位,即$G_{|1,…,i}\xrightarrow{alg}G_{|i+1} $,这个流密码也是不安全的。
- 如果使用流加密,且攻击者掌握一部分密文,并且这部分密文对应的消息是固定的,就像
-
几个弱
PRG,这几个PRG不应该被使用于加密:- 线性同余生成器
LCG - GLIBC库中的伪随机数生成器
- 线性同余生成器
-
可忽略与不可忽略的概念(不同密码学领域对这两个的定义不同):
- 偏密码学实践:这个可忽略或者是不可忽略的量其实是一个标量,例如是不可忽略的,是可忽略的。
- 偏密码学理论:一个由的函数。
- 对于不可忽略而言;其中存在无穷多个参数使得,例如是不可忽略的。
- 对于可忽略而言;只要 足够大就会使得,例如是可忽略的。
流密码的攻击
- 首先我们先对
OTP进行攻击操作分析,在现实中通常会因为某些原因导致在进行OTP加密的时候,相同的密钥加密了两个不同的消息,这就导致了OTP的保密性失效了;还有一个对OTP的攻击是对加密的密文进行扰动或者篡改,因为OTP不具有完整性它的密文很容易被改变。这些对OTP攻击的手法也可以使用到流密码中。 - 攻击1:破解整个消息,假设两个消息都被相同的密钥加密。
- 当相同的密钥加密不同的消息时:
- 破解思路:对两个密文进行异或,由于英文字母及其编码成
ASCII时都有足够的冗余,所以得到两条明文消息的异或值(本质上是两条ASCII编码后消息的异或)。实际上可以完全恢复这两条消息。 - 例子1:
维诺纳计划,Project Venona ,1941-1946苏联人使用OPT加密各种消息,但他们使用的密码本由人工掷骰子生成,这就使得密钥生成的成本过高,所以他们使用一个密钥加密多条消息,这就使得他们的消息被美国破解。 - 例子2:
MS-PPTP,Windows NT,在MS-PPTP的一个点对点隧道协议中,该协议要保证客户端与服务器安全通信,但该协议是将消息变成消息流;该协议使用流密码的方式用密码进行加密,服务器也使用流密码,但服务器中使用了相同的随机数种子。 - 例子3:在802.11协议中,有一个
WEP加密层,该层在加密过多消息后,向量IV会产生循环,导致相同的密钥加密了多个不同的消息。事实上,WEP中的PRG是RC4,在2001年由Fluhrer发现对RC4的攻击,表明在大约帧的流量就可以恢复密钥;现在,大约40000帧就能恢复密钥了。 - 例子4:在磁盘加密中,若使用流密码的方式加密磁盘,头一次攻击者分析不出什么,但当用户在修改过文件的一些数据后,再次保存到磁盘,磁盘再使用相同的密钥加密,攻击者就可以对这两次加密后的磁盘做对比,很容易知道用户改动的位置,因此使用流密码加密磁盘是不安全的。
- 攻击2:篡改密文,假设一个
OTP- 第一步:攻击者拦截了密文,但不知道对应的明文。
- 第二步:攻击者使用序列对该密文进行扰动即进行,并将改动后的密文发送给接收方。
- 攻击结果:接收方解密后会得到,解密后的数据可能是不可读的一串乱码或者是与原消息意思不同的明文。
- 例子1:一般邮件或者信封都有固定格式电子邮件也不例外,当用户发送了一封
from Bob开头的信并用流密码加密,而攻击者拦截了密文,并且知道是Bob发送的信封,攻击者就可以对其进行篡改将进行如下运算,这样收信人解密后,看到的信封开头就是from Eve。
常见的流密码
-
RC4流密码:RC4流密码设计于1987年,是软件实现的流密码。RC4加密过程大致如下:- 接受可变大小的种子(其实就是密钥长度不是固定的),在实际层面一般是
128位,但不做强制要求。 - 将输入的种子也就是密钥扩展成
2048位,这2048位将被用作生成器的内部状态。 - 接着就进入一个非常简单的循环,该循环每次迭代都输出一个字节。(实际上可以一直运行该生成器,每次生成一个字节)
- 接受可变大小的种子(其实就是密钥长度不是固定的),在实际层面一般是
- 在过去,
RC4加密通常用在HTTPS、WEP协议中。 RC4流密码又如下缺陷:- 对于
RC4而言,第二个字节为0的概率会偏大,即,这就意味着如果用RC4加密消息,很可能出现第二个字节没有被加密的情况。所以如果要使用RC4加密最好是忽略其输出的前256字节,从第257字节开始使用生成器输出。 - 使用
RC4加密得到连续的16位(2字节)都是0的概率会更高,概率为: - 使用
RC4加密可以使用相关密钥攻击破解。
- 对于
-
CSS流密码(已经被证明很容易被破解):CSS流密码是硬件实现的流密码,曾经使用CSS流密码加密DVD。- 在介绍
CSS流密码之前先要介绍一下线性反馈移位寄存器LFSR,CSS是基于LFSR构造出来的PRG,:- 首先
FF0、FF1、FF2、...、FFn会被初始化bit位。(LFSR的初始状态其实就是种子) - 接着
CLK时钟,发出一个脉冲,这就会使得 - 的值输出出去(其中输出其实还要画一个箭头,这边只有参与异或的箭头),的值会输出到两个地方,其中一个地方是输出给用户使用,另一个输出是参与生成下一个
FF0的运算。 - 接着的值就会被输出(移动)到这个寄存器中,的值就会被输出(移动)到这个寄存器中,以此类推,这就是移位
- 输出的过程中,其实还会将输出的值输出给就会参与运算,运算的结果就是的值,这就是反馈。
- 首先
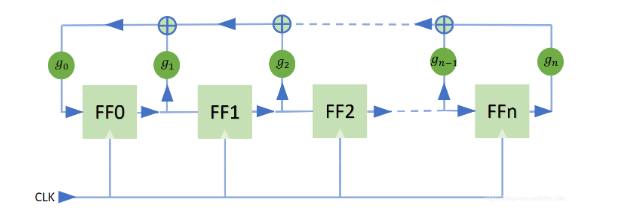
LFSR是很多流密码的基础,如下所示,但是下面的流密码算法都被破解了:CSS流密码:2LFSR结构A5/1、A5/2加密GSM:3LFSR结构E0:4LFSR结构
- 接下去介绍一些
CSS流密码的加密算法:CSS流密码的密钥为5字节(40位),因为当时美国出口法只允许出口密钥仅为40位的密码算法。CSS流密码使用两个LFSR的结构,一个是17位的LFSR,另一个是25位的LFSR。- 对于
17位的LFSR初始状态为1+密钥的前两字节,对于25位的LFSR初始状态为1+密钥的后三字节 - 两个LFSR都运行
8个周期,分别都产生1字节的序列 - 利用加法器将这两个字节相加(做模256的加法),加法过程中要加上前一块的进位。
- 模256加法后的结果作为输出被使用,用于加密DVD电影数据的适当字节。
CSS加密的破解:- 攻击者拦截到被加密的DVD数据,而DVD加密碰巧是MPEG这个文件格式,这时利用文件头的固定格式就可以知道CSS的一些序列(假设文件头20字节,那么就可以得到CSS输出的前20字节)
- 通过这前20字节再去寻找和验证
17位的LFSR和25位的LFSR初始状态 - 恢复初始状态后就可以预测之后的随机序列,从而解密电影剩余的部分。
-
上面介绍了一些过时的流密码,而现在有更好的
PRG,有一个estream项目,该项目结束于2008年。estream选出了七种流密码:- 适用于软件的:
HC-128、Rabbit、Salsa20/12、SOSEMANUK - 适用于硬件的:
Grain v1、MICKEY v2、Trivium - 接下来主要介绍
Salsa20的加密过程,Salsa20可以使用软硬件实现。
- 适用于软件的:
-
Salsa20流密码:- 补充:这些比较新的流密码和旧的流密码相比,输出上多了一个
nonce,具体映射如下,其中就是nonce的集合,所谓nonce就是在密钥给定的条件下永远不会重复的值。 Salsa20的流密码映射如下:,Salsa20接收128或256位密钥,这里以接收128位为例子。Salsa20的流密码定义为:,其中是一个函数,是密钥,是nonce,0,1,...,是逐步递增的计数器,该计数器从零开始。- 函数
H的具体内容如下:- 将状态扩展成长度为
64字节的状态:1-4字节是常数5-20字节是密钥21-24字节是常数25-32字节是nonce33-40字节是计数器41-44字节是常数45-60字节是密钥61-64字节是常数
- 使用一个函数,该函数将字节映射到字节,并且该函数可逆(本质上就是
可逆置换,但不是permutation这个置换,而是由 ARX(加、旋、异或)构成的混合变换),这个函数在硬件中很容易被实现,例如在x86上有SSE2指令集支持该函数的所有操作(因此该流密码非常快) - 再使用函数得到另外字节,以此类推置换十次。
- 置换十次得到的结果于最初的状态进行加法,以4字节为单位加法。
- 将状态扩展成长度为
- 对于
Salsa20没有影响比较大的攻击,其安全性非常接近
- 补充:这些比较新的流密码和旧的流密码相比,输出上多了一个
统计质量良好的PRG和安全的PRG
-
对于一个
PRG,不光要符合PRG的定义,还需要满足一些统计检验,当某个PRG能通过一组统计检验,那么该PRG就是统计质量良好的PRG;当某个PRG能通过任何一组高效的统计检验,那么该PRG就是安全的PRG。 -
对于统计质量良好的
PRG和安全的PRG的定义都是基于如下目标:- 假设的函数映射为:
- 目标是:对于
PRG的输出与随机输出不可区分。- 定义一个分布随机分布,该分布是从密钥空间中选择一个随机密钥即(代表均匀选取),接着会输出。
- 定义另一个分布随机分布,该分布即从\set{0,1}^{n}中均匀选取,并将输出出来
- 攻击者同时拥有和,但是它不知道生成的是来自还是,不知道生成的是来自还是,区分不出来两者生成的数或字符串等就是
PRG的输出与随机输出的不可区分,这就是统计质量良好的PRG和安全的PRG定义的出发点。
- 直观理解:\set{0,1}^{n}是大集合,但由于是小集合对应法则的值域其实是其陪域\set{0,1}^{n}中很小的一部分子集,需要设计出随机从中的值域选取一个数和随机从陪域中选取一个数,我们无法区分两者到底来自哪个集合。
-
统计检验:
- 在\set{0,1}^{n}上的统计检验定义为:统计检验是一个算法,通常用表示,该算法以位字符串作为输入即,并简单输出或者,其中输出表示字符串不是随机的即是来自;其中输出表示字符串事实上是随机的。
- 在
PRG的统计检验中,有一个概率性结论:对于一个随机字符串,0的数量大致等于字符串中1的数量。- 例子1:有一个统计检验算法,该算法会计算并判断,如果小于该算法就会输出,即看似随机(是计算中
0的个数,同理) - 例子2:如果,则在统计检验中有,即看似随机(是计算出中有两个连续的
0的个数) - 例子3:有一个统计检验算法,该算法会先计算出的值和的值,如果,那么,即看似随机;但是该统计检验认为全字符串也是看似随机的。(是统计中连续为1的部分最长的长度)
- 例子1:有一个统计检验算法,该算法会计算并判断,如果小于该算法就会输出,即看似随机(是计算中
-
统计质量良好的
PRG:- 设有一组统计检验,并且满足,即来自
PRG生成的字符串都认为其看似随机,那么该PRG就被称为统计质量良好的PRG。 - 注意:统计质量良好的
PRG并不代表该PRG是安全的,例如MT19937,它是统计质量良好的PRG,但在一定条件下它能被预测所以它不是安全的PRG。
- 设有一组统计检验,并且满足,即来自
-
评估统计检验的好坏
优势,advantage:- 设
PRG满足映射G:K\to \set{0,1}^{n},且是一个在\set{0,1}^{n}上的统计检验,则Adv_{PRG}[A,G]:=|\underset{k\xleftarrow{R}K}{Pr}[A(G(k))=1]-\underset{k\xleftarrow{R}\set{0,1}^{n}}{Pr}[A(r)=1]|,其中,该式子表示的是统计检验在检验PRG生成的字符串为随机的概率与检验真随机生成的字符串的概率为随机的概率绝对差。 - 当,统计检验可以基本上区分
PRG和真随机,尽管的输出结果与实际不符合(如,而\underset{k\xleftarrow{R}\set{0,1}^{n}}{Pr}[A(r)=1]\to 0) - 当,表示统计检验在伪随机输入上行为几乎与在真随机输入上一样,即不能区分真随机与伪随机。
- 例子1:,该统计检验不论输入什么字符串,它都只输出,那么则
- 例子2:假设有一个特殊的
PRGG:K\to \set{0,1}^{n},满足,这个条件的密钥占密钥空间的,定义一个统计检验,当时,;其他情况下,所以。我们就说以的优势破解了生成器,这就意味着该PRG不是一个很好的PRG。
- 设
-
安全的PRG密码学定义,也称
CSPRG,Cryptographically Strong Pseudorandom Generator,密码学强PRG或者是CSPRNG,Cryptographically Secure Pseudorandom Number Generator,密码学安全PRNG:- 对于,且必须是高效的,有是可忽略的,即,那么
PRG是安全的PRG。 - 注意:高效的统计检验这个前提是必须的,限制在
高效是正确的。
- 对于,且必须是高效的,有是可忽略的,即,那么
-
构造并证明
PRG它是密码学安全的PRG:-
实际上,目前尚不清楚是否存在任何可证明的安全
PRG,如果要证明那就相当于证明了 -
虽然无法严格证明安全的PRG,但是我们仍然有非常多启发式候选方案
-
CSPRG的一些事实、定理:- 定理1:
CSPRG是不可预测的 - 定理2:设G:K\to \set{0,1}^{n},如果\forall i\in \set{0,..,n-1},在已知
PRG前个比特的前提下,无法预测第比特,那么该PRG是安全的。(该定理将对CSPRG的不可预测性和对CSPRG定义中不可区分性联系起来)
- 定理1:
-
扩展:从均匀分布的不可区分性到两个在\set{0,1}^{n}上的一般分布的不可区分。
- 定义:如果,是高效的统计检验,都满足,其中可忽略,那么在计算上不可区分
- 例子:CSPRG:\set{k\xleftarrow{R}K:G(k)}\approx_P uniform(\set{0,1}^{n})
-
分组密码
 wechat